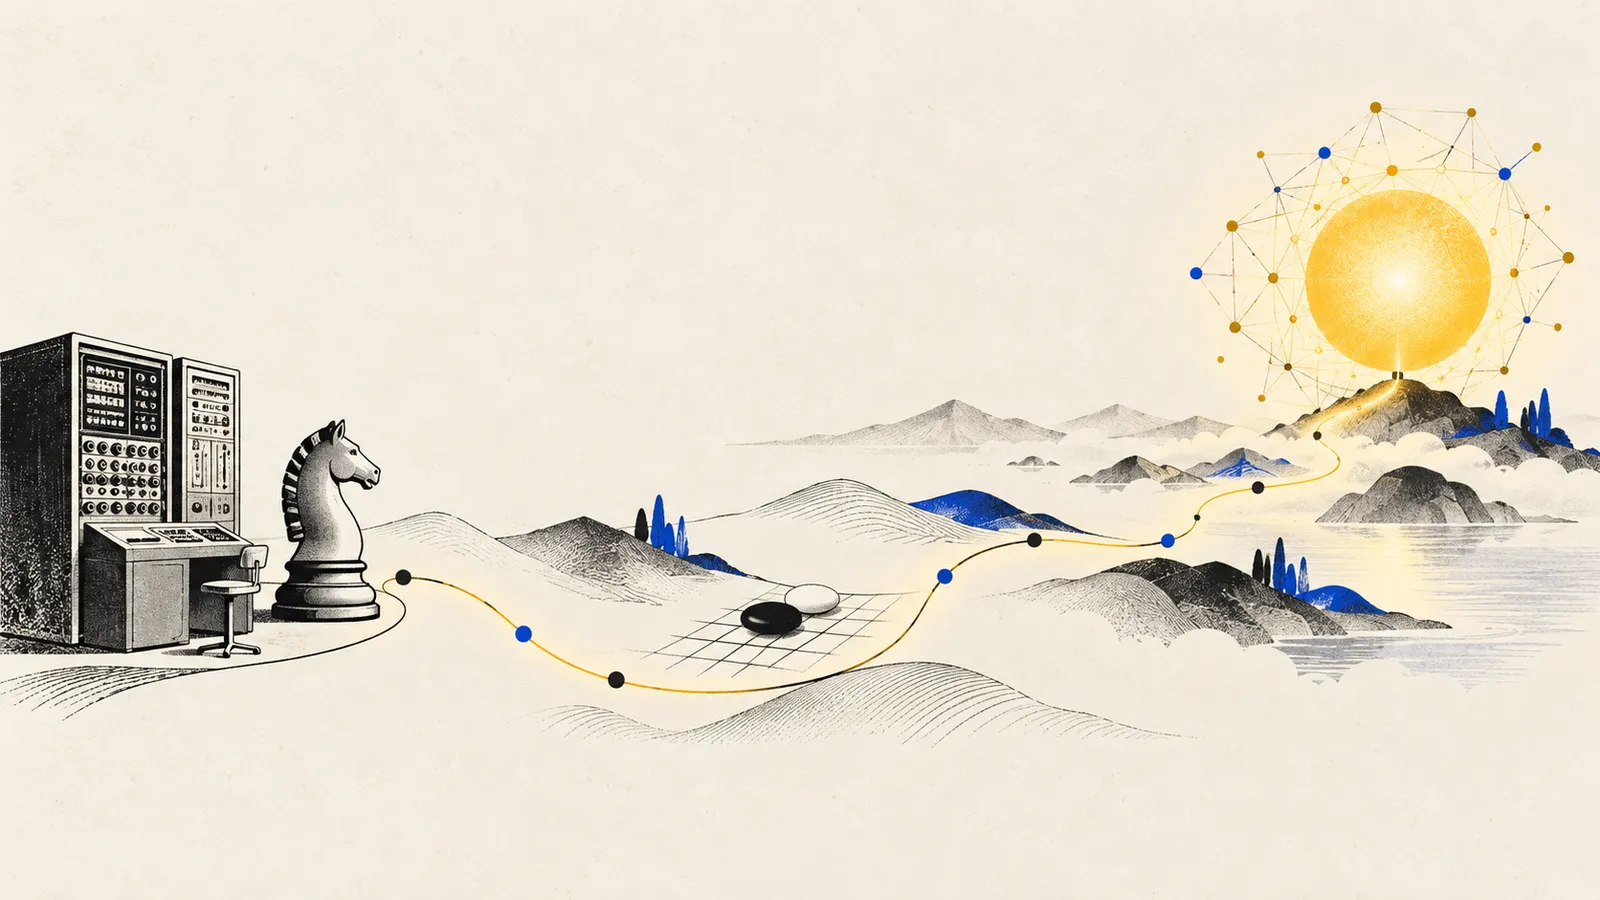
Breve storia dell'intelligenza artificiale, da Turing a GPT-6
Settantasei anni in dieci capitoli: le idee, gli inverni, le svolte e le persone che hanno portato all'AI di oggi. Per capire perché proprio ora, e cosa può succedere dopo.
 Mattia PanattaAggiornato il 13 ottobre 202612 minBase
In breve
- L’idea di “macchine che pensano” ha più di settant’anni; il nome “intelligenza artificiale” nasce nel 1956.
- Per decenni hanno dominato le regole scritte a mano; dal 2012 vincono le reti neurali che imparano dai dati.
- Tre ingredienti hanno fatto esplodere tutto: dati (internet), calcolo (le GPU), un’architettura (il Transformer, 2017).
- La storia dell’AI è fatta di entusiasmi e “inverni”: conoscerla aiuta a leggere con lucidità anche l’euforia di oggi.
1950: la domanda di Turing
Nel 1950 il matematico britannico Alan Turing pubblica un articolo che inizia con una domanda semplice: le macchine possono pensare? Invece di definire “pensare”, propone un esperimento, il gioco dell’imitazione: se, conversando per iscritto, non riesci a distinguere una macchina da una persona, che senso ha dire che la macchina non pensa?
Il test di Turing è stato criticato per decenni, ma ha fissato un’idea che ritroviamo intatta in ChatGPT: giudicare l’intelligenza dal comportamento, non da ciò che c’è dentro.
1956: nasce un nome (e un’ambizione)
Nell’estate del 1956, al Dartmouth College, un gruppo di ricercatori tra cui John McCarthy, Marvin Minsky e Claude Shannon organizza un seminario con un obiettivo dichiarato: descrivere ogni aspetto dell’apprendimento e dell’intelligenza così precisamente da poterlo far simulare a una macchina. McCarthy conia per l’occasione il termine intelligenza artificiale.
L’ottimismo è enorme: si pensa che in una generazione le macchine eguaglieranno l’uomo. Non andrà così.
Anni ’60-’80: regole, sistemi esperti e due inverni
La prima AI è simbolica: si cerca di codificare la conoscenza in regole logiche (“se il paziente ha la febbre e la tosse, allora…”). Negli anni ’80 i sistemi esperti hanno un successo commerciale reale, in medicina, finanza, industria.
Ma le regole scritte a mano non scalano: il mondo è troppo vario, le eccezioni infinite. Due volte, a metà anni ’70 e a fine anni ’80, i finanziamenti crollano. Sono gli inverni dell’AI: periodi in cui la promessa supera di molto la realtà e il mercato se ne accorge.
Intanto, ai margini, un’altra idea sopravvive: le reti neurali, ispirate (molto liberamente) ai neuroni del cervello, che invece di seguire regole imparano dagli esempi. Nel 1986 Geoffrey Hinton e colleghi rendono popolare la backpropagation, il metodo per addestrarle che usiamo ancora oggi.
1997: Deep Blue batte Kasparov
Il computer di IBM sconfigge il campione del mondo di scacchi. È un evento mediatico enorme, ma tecnicamente è il trionfo della vecchia scuola: forza bruta (milioni di posizioni al secondo) e conoscenza scacchistica scritta da esperti. Deep Blue non sa fare nient’altro.
2012: la svolta del deep learning
Al concorso ImageNet, dove i programmi devono riconoscere oggetti in milioni di foto, una rete neurale “profonda” chiamata AlexNet, del gruppo di Hinton a Toronto, stacca tutti gli avversari. Il segreto: tanti dati, una rete con molti strati, e le GPU, i processori delle schede video, usate per fare in parallelo milioni di calcoli.
Da quel momento il deep learning diventa la strada principale. In pochi anni arrivano riconoscimento vocale, traduzione automatica e visione artificiale di qualità mai vista. E NVIDIA, che produce le GPU, inizia la sua trasformazione nell’azienda simbolo dell’AI.
2016: AlphaGo e la “mossa 37”
DeepMind, il laboratorio fondato da Demis Hassabis e acquistato da Google, batte Lee Sedol a Go, un gioco considerato troppo complesso per la forza bruta. Nella seconda partita AlphaGo gioca una mossa, la numero 37, che i commentatori giudicano un errore: era geniale. Per la prima volta una macchina mostra qualcosa di simile alla creatività in un dominio umano raffinato.
2017: il Transformer
Otto ricercatori di Google pubblicano Attention Is All You Need e presentano il Transformer, un’architettura basata sul meccanismo di attenzione (lo spiego nella guida su come funziona un LLM). È più efficiente delle precedenti e, soprattutto, migliora in modo prevedibile quando cresce: più dati e più calcolo, risultati migliori.
È la chiave di tutto ciò che segue: la “T” di GPT sta proprio per Transformer.
2018-2022: crescere, crescere, crescere
OpenAI scommette sulla scala: GPT-1 (2018), GPT-2 (2019), GPT-3 (2020), ogni volta molto più grande. Con GPT-3 succede qualcosa di inatteso: il modello sa fare compiti per cui non è stato addestrato, solo leggendone qualche esempio nel testo. Nello stesso 2020 AlphaFold 2 di DeepMind risolve di fatto il problema della previsione della forma delle proteine, un risultato che varrà un premio Nobel.
Poi, il 30 novembre 2022, OpenAI rende pubblico ChatGPT: lo stesso tipo di modello, addestrato a conversare e reso facile da usare. Cento milioni di utenti in circa due mesi. L’AI esce dai laboratori ed entra nelle case.
2023-2025: la corsa
Arrivano GPT-4, Claude, Gemini, Llama e i modelli aperti; i generatori di immagini e video; i primi agenti. Nel 2024 i modelli di ragionamento imparano a “pensare” prima di rispondere, l’AI Act europeo entra in vigore e i premi Nobel vanno all’AI: fisica a John Hopfield e Geoffrey Hinton per le reti neurali, chimica a Demis Hassabis e John Jumper (con David Baker) per le proteine. Nel gennaio 2025 la cinese DeepSeek mostra che modelli molto capaci si possono costruire spendendo molto meno del previsto. In Italia arriva la legge 132/2025.
2026: dagli assistenti agli agenti
Oggi siamo qui: GPT-6, Claude Opus 5.5, Gemini 4 Argon, Muse Wonder. Le risposte diventano interfacce interattive, gli agenti lavorano per ore, i costi per compito crollano. Ne parliamo nelle notizie e nelle opinioni di questo sito.
Cosa insegna la storia
- Le previsioni sbagliano in entrambe le direzioni. Nel 1956 si pensava di risolvere tutto in vent’anni; nel 2015 quasi nessuno immaginava ChatGPT entro il 2022.
- Le idee vincenti spesso aspettano. Le reti neurali sono degli anni ’50, la backpropagation degli anni ’80: mancavano dati e calcolo.
- Gli inverni arrivano quando la promessa supera la realtà. Oggi la tecnologia mantiene molte promesse, ma valutazioni e aspettative corrono più veloci (ne parlo nell’opinione sulla bolla).
- Dietro ogni svolta ci sono persone e scelte. Non è un destino tecnologico: è una storia umana, e possiamo ancora influenzarla.
Vuoi la storia completa?
Questa è la versione in dieci capitoli. Nell’ebook di Lumen la storia dell’AI è raccontata per intero, con le persone, i contesti e i retroscena, insieme a strumenti, regole e futuro.
Fonti
Contenuto informativo aggiornato alla data indicata. Prezzi, modelli e norme cambiano spesso: verifica sempre sulle fonti ufficiali. Testo scritto con il supporto di strumenti di AI e rivisto dall'autore.